看见网络训练:从 XOR 到加法器
Table of content
看见网络训练:从 XOR 到加法器
1. 梯度算完之后,网络发生了什么
上一篇讲清了反向传播:先前向算出各层输出,再把误差往回传,最后沿梯度的反方向调整参数。
公式告诉了我们怎么调整,但几百个参数一起变化,光看数字很难形成直觉。把它们画出来,就能观察训练在做什么;再把任务从 XOR 换成加法,也能看看前面学过的方法如何用于更复杂的问题。
下面这段动画展示了一个加法器网络的参数变化。左边是 8 个输入,中间是 8 个隐藏层神经元,右边是 5 个输出。
先留意一个现象:圆点和连线的位置始终没变,变化的是颜色。这正是这个全连接网络的训练方式——结构事先确定,训练调整的是连接上的权重和各个神经元的偏置。
2. 颜色能告诉我们什么
前文把每层计算拆成了三步:输入乘权重、加偏置、经过激活函数。图里也按这个关系表示:
- 圆点表示神经元,每一列是一层。
- 连线表示相邻两层之间的连接,颜色表示权重。
- 隐藏层和输出层圆点的颜色表示偏置,输入层统一画成灰色。
注意,这里圆点的颜色表示偏置,不表示激活值。偏置是训练要调整的参数;激活值则是给定输入后,神经元算出的结果。因此,这段动画展示的是参数在训练中的变化,并没有展示某个输入在各层之间的传递过程。
权重和偏置可正可负,范围也不固定。为了把它们变成颜色,可以先用 sigmoid 把数值压到 0 到 1,再按这个比例混合紫红色和绿色:
| 参数值 | 图上的颜色 |
|---|---|
| 较大的负数 | 接近紫红色 |
| 接近 0 | 接近灰色 |
| 较大的正数 | 接近绿色 |
这次使用 sigmoid 只是为了显示,并不改变参数本身。对同一条连接来说,在其他条件相同时,正权重让上游输入的增大推高下游的加权和,负权重则让它降低。颜色把这种方向上的区别直接画了出来。
对比动画中较早和较晚的两个时刻:
| 训练较早时 | 训练较晚时 |
|---|---|
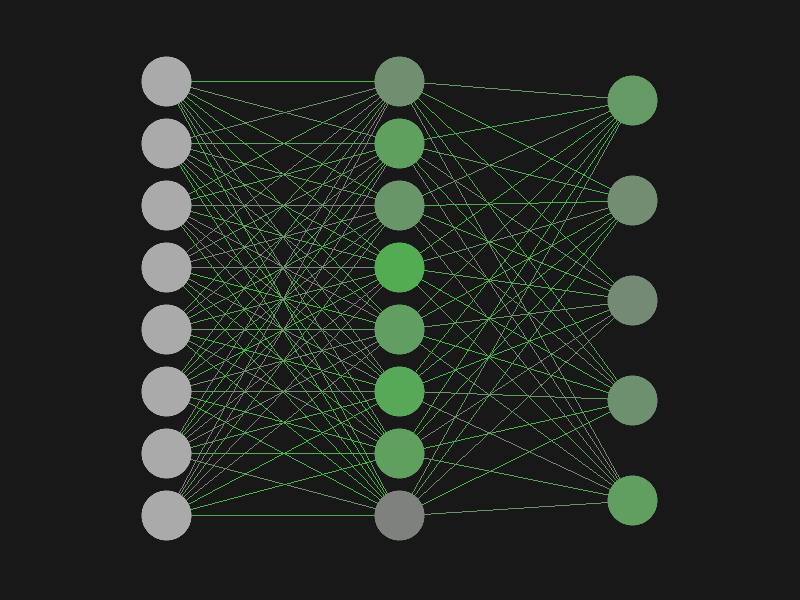 | 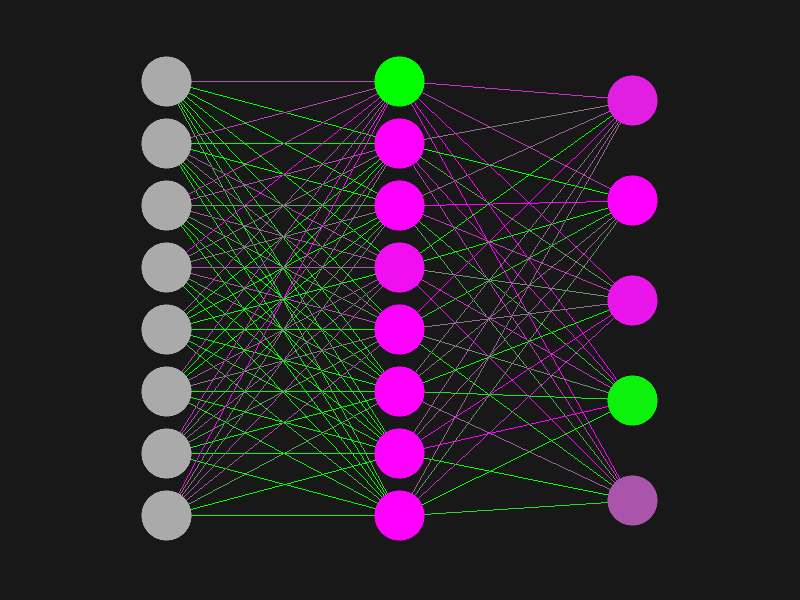 |
这个例子的初始参数在 0 到 1 之间,所以颜色集中在灰绿附近。随着训练进行,参数逐渐分开:有的更正,有的变成负数。原本相近的连接开始以不同的方向和强度影响后面的计算。
不过,颜色只能表达大致大小。当参数绝对值很大时,sigmoid 已经接近两端,参数继续变化,颜色也可能几乎不动。画面稳定不能单独证明训练收敛,颜色分明也不能证明预测正确。
3. 学习加法之前,先决定怎么表示数字
XOR 的输入是两个二进制位,输出也是一位。换成两个整数相加,第一件事是决定如何把整数交给网络。
这里考虑两个 0 到 15 的非负整数,每个数可以拆成 4 个二进制位。两数之和最多是 30,需要 5 位才能完整表示:
| 部分 | 表示方式 | 数量 |
|---|---|---|
| 输入 | 第一个数的 4 位,接上第二个数的 4 位 | 8 个输入 |
| 输出 | 和的低 4 位,再加最高位进位 | 5 个输出 |
例如 3 + 5 = 8。如果约定低位在前,数据就这样排列:
| 数值 | 通常写的二进制 | 交给网络的顺序 |
|---|---|---|
| 3 | 0011 | 1, 1, 0, 0 |
| 5 | 0101 | 1, 0, 1, 0 |
| 8 | 01000 | 0, 0, 0, 1, 0 |
因此,输入是 1, 1, 0, 0, 1, 0, 1, 0,期望输出是 0, 0, 0, 1, 0。高位在前也可以,关键是制作样本、输入网络和解释输出时始终遵守同一个顺序。
两个数各有 16 种取值,一共只有 16 × 16 = 256 组组合,可以全部列出来作为样本。每组样本由两个部分组成:两个加数的二进制位,以及正确结果的二进制位。
这里要分清提供正确答案和告诉网络怎么算。我们用普通加法制作标签,但网络接收的只是输入位;它需要根据预测与标签之间的误差,调整自己的参数。
加法也把 XOR 的问题往前推进了一步:最低位的和就是两个输入位的 XOR,而更高位还要考虑低位传来的进位。例如 7 + 1 = 8,二进制从 0111 + 0001 变成 1000,进位一路影响到更高位。网络要拟合的,正是这些输入位之间的关系。
4. 输出变多了,学习方法仍然相同
对这个问题,可以尝试一个“8 个输入 → 8 个隐藏层神经元 → 5 个输出”的全连接网络,也就是动画中的结构。
输入和输出的数量由数据表示决定,隐藏层宽度则是模型的选择。取 8 个隐藏层神经元是一个实验配置,并不意味着它一定足够,也不保证训练一定成功。
这个网络共有:
- 输入到隐藏层:
8 × 8个权重,加 8 个偏置。 - 隐藏层到输出层:
8 × 5个权重,加 5 个偏置。
合起来是 117 个参数。参数比 XOR 多了,学习过程却没有新增步骤:
输入二进制位 → 前向计算五个输出 → 与正确答案比较
            → 反向传播求梯度 → 调整参数 → 再来一轮
误差也可以沿用前文的平方误差。只是原来每个样本只有一个输出,现在要把五个输出的误差平方相加,再对全部样本取平均。
每个输出都贡献一部分误差。隐藏层同时连接五个输出,所以它的梯度也要汇总这些下游路径的贡献。这正好对应上一篇讲过的“误差为什么要相加”:一个参数影响了多个结果,求导时就要把各条路径的影响加起来。
如果采用整批训练,就先计算所有样本的梯度并取平均,再统一更新参数。无论输出是一位还是五位,都遵循前文“在同一组参数上算梯度,再一起更新”的顺序。
5. 怎样判断网络真的学会了
输出层经过 sigmoid,得到的是 0 到 1 之间的小数。要把它还原成二进制位,可以约定:大于 0.5 判为 1,否则判为 0,再按位拼回整数。
但观察训练时,有几个不同的问题需要分别回答:
| 观察内容 | 回答的问题 |
|---|---|
| 参数动画 | 哪些权重和偏置在变化,变化大致有多大? |
| 误差数值 | 连续输出整体上离目标还有多远? |
| 每一位的预测 | 哪些位容易出错,进位有没有判断对? |
| 完整结果的正确率 | 有多少组加法的五个位全部正确? |
这些结果不能互相替代。误差下降,表示输出整体上更接近标签,但某一位仍可能落在 0.5 的错误一侧;多数位正确,也不等于整数结果正确。
例如 9 + 8 = 17,正确的五位结果是 10001。只判断出最高位为 1,只能说明知道结果超过了 15;低四位如果错了,仍然没有算出 17。评价加法任务时,应该按完整结果是否正确统计。
训练表现也不能替代梯度检查。如果怀疑参数更新有问题,仍然可以用前文的有限差分逐项核对。动画能帮助发现现象,数值对照才能判断梯度是否符合公式。
最后,还要区分“拟合了这些样本”和“掌握了可推广的规律”。如果全部 256 组输入都参与训练,再检查同样的 256 组,得到的是这个范围内的拟合情况。即使全部算对,也不能据此推断它能处理更多位数或更大的整数。
从 XOR 走到加法器,值得掌握的是这三个步骤:先把问题表示成输入和目标,再用统一的训练过程调整参数,最后用与任务一致的标准检查结果。 可视化让中间的变化更容易理解,而学习是否有效,要由完整的预测结果来回答。